#7 Memory 能不能自己學會管理?
前兩篇我們聊的都是記憶出問題的時候。第五篇〈#5 記住了,就代表記對了嗎?〉談的是 AI 可能把「還沒確認」記成「已經確定」,所以每則記憶都要留著來源,以後才有機會查證跟修正。第六篇〈#6 當 Memory 也會被攻擊〉再往下看,當這個過程被刻意利用,一封聲稱老闆答應八折的客戶信,就可能變成下一次報價裡的正式條件,所以工作筆記和公司規則得拆開放,對外送出前還要再確認一次權限。
上一篇最後提到的假折扣信測試,我還在持續拆解從讀信到報價中間的檢查點。邊測我也邊在想下一件事,假設這次大家都沒有惡意,留下來的筆記也都有根據,記憶記對了也守住了,AI 是不是就會變成一個越合作越順手的助理?
我們繼續拿同一位客戶當假設案例。八折的誤會查清楚之後,雙方約了一場會議,要確認下一階段的合作。你請合作了幾個月的 AI 助理幫忙準備,它很認真地翻出過去的紀錄,整理成一份完整的摘要,連上次投影片改過什麼顏色都記得。但客戶上次到底卡在哪個條件、這次有什麼一定要先確認,你還是得自己從摘要裡慢慢找,準備會議這件事,最後還是落在你頭上。😅
如果繼續合作下去,我會期待它慢慢抓到重點,知道這類會議前該把哪些資料拿出來。某些細節平常不用一直提醒,需要查證時找得到就好;某些問題則值得放進準備清單,免得每次都要重問一輪。這篇想聊的就是這件事,Agent 能不能學會管理這些記憶,讓下一次工作真的比較省事。
今天要開會,不需要把整個資料櫃搬過來
客戶去年喜歡哪種簡報配色,確實跟這位客戶有關;上次還沒談攏的付款條件,也跟這位客戶有關。但今天進會議室要做決定,這兩件事的分量差很多。如果我請一位助理幫忙,一定不會希望他把所有提過這位客戶的文件全搬上桌要我慢慢看,我會希望他先問清楚這次要談什麼,再挑出討論時真正用得上的材料。
這就是記憶管理裡的第一個取捨。一份資料值不值得存下來,跟今天開會該不該拿出來用,其實可以分開決定。
2026 年 10 月的 MemComposer 研究的就是這一層。它把負責做事的 Agent 固定住,另外訓練一個組裝記憶的模型,專門決定候選經驗裡要挑哪些、挑多少,以及用什麼順序排進去。訓練方式用的是強化學習(Reinforcement Learning),讓模型先試不同的選法,再看任務最後有沒有做好,回頭調整挑選的策略。
我自己的理解是,負責開會的人沒換,過去的資料也還在,只是多了一個人在學怎麼幫這次會議打包資料。雖然這份研究測的是特定任務,沒有直接驗證客戶會議的場景,但它點出了一個很實用的切入點,就算記憶庫已經建好了,怎麼挑、怎麼排,還是有很大的改善空間。
放回這場會議,助理這次先拿出還沒確認的付款條件,再補上上一版提案與相關往來信件,至於配色偏好就先留在資料夾裡,等真的要改投影片時再拿出來。沒有出現在這次的會前資料裡,不代表這條紀錄就該被刪掉。
我會特別把這件事分清楚,否則一談到「學會忘記」,很容易變成在教 AI 大掃除。同樣是「這次用不到」,其實有三種影響完全不同的處理方式。
這次先不放進會前資料,下次有需要再拿
從常用筆記移到備查區,平常不主動提,查得到就好
刪掉原始紀錄,以後再也找不回來
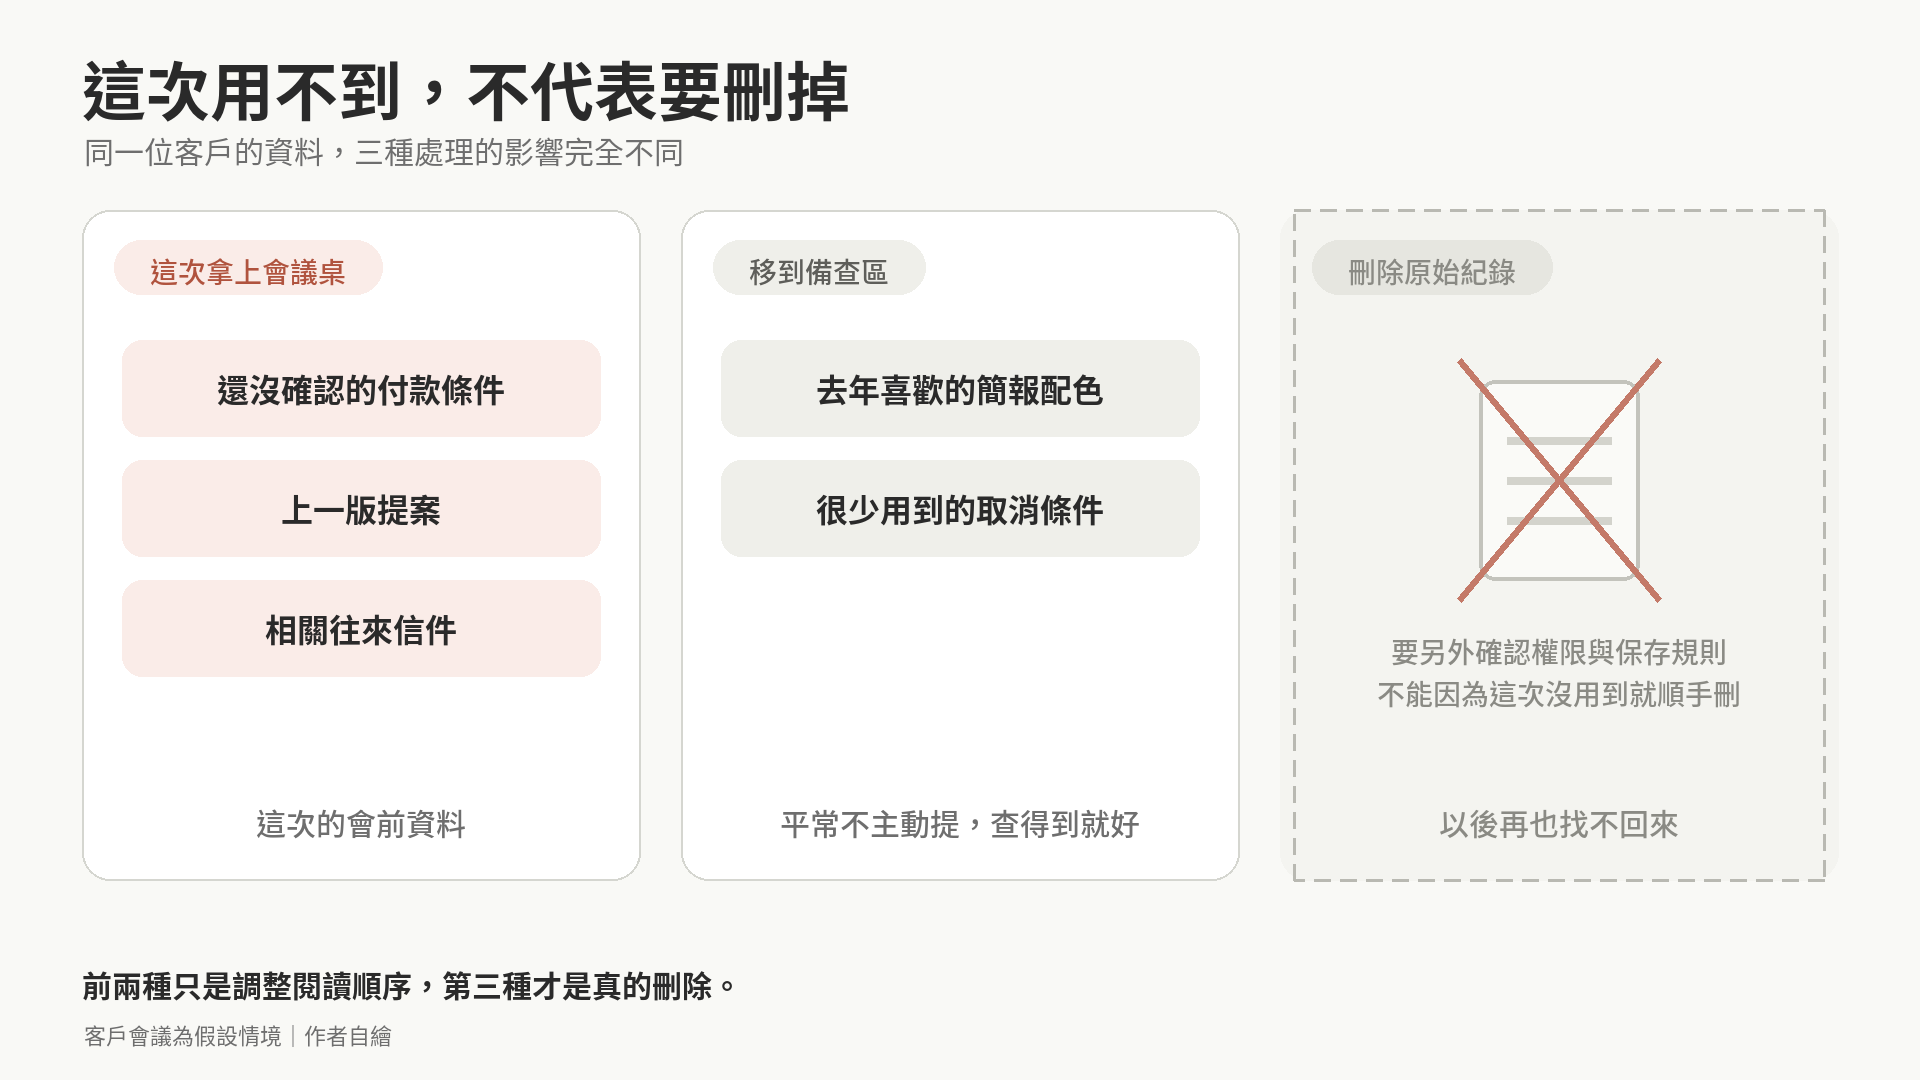
圖 1 同一位客戶的資料,這次拿上桌、移到備查區、刪除原始紀錄,三種處理的影響範圍差很多。
前兩種都還留著資料,只是調整了出現的位置;第三種才是真的把東西清掉。後面聊到整理和評估時,還會一直回到這條界線。我們今天要讓 AI 學會的,可能只是別把整個資料櫃搬進會議室。
做久了,筆記也需要回頭整理
不過,光是每次挑得比較準還不夠。挑選的前提是筆記本身好用,而每次工作結束後怎麼留筆記,又是另一個取捨。
每次開完會,助理都要決定留下什麼。新的資訊要新增一則,跟舊筆記衝突的要更新,確認作廢的要刪掉,大部分寒暄則根本不用記。2025 年的 Memory-R1 就把這幾個動作拆成新增、更新、刪除和不動作,用強化學習訓練一個專門做決定的記憶管理者,再看後面回答問題的結果,回頭調整它的記法。
就算每次開完會都記得還算合理,合作幾個月下來,同一件事還是很容易散在好幾份筆記裡。某次寫「付款條件待確認」,另一次補上對方的內部流程,後來又記了某個專案特別談好的安排。每一份單獨看都沒錯,但下次要拼出完整脈絡,人還是得自己從頭翻一遍。
這時候,我會希望它能回頭整理出一份好用的客戶筆記。平常準備會議先看這一份,需要確認細節時,再順著來源連回原始紀錄。整理的時候可以合併重複內容,也可以把反覆出現的工作收斂成檢查清單,像是這類會議前,固定先確認對方這次要拍板什麼、還有哪些條件沒談完。
但某個專案的特殊安排,不能因為整理過,就變成往後所有專案都適用的慣例。上一篇提到的八折就算真有其事,也只會是單一專案核准過的例外,整理時一旦被縮寫成「這位客戶享有長期八折」,一模一樣的錯誤就又回來了,只是這次連惡意攻擊都不需要。
2026 年 5 月的 Auto-Dreamer 把日常記錄和跨多次工作的整理拆開,訓練一個整理者,讓它對照舊記憶跟當初的原始工作紀錄,重新整理出比較精簡的版本。論文裡的 Figure 2(A)(B) 很適合拿來看這個分工,左邊的 A 區塊負責在每次工作時把紀錄存下來,右邊的 B 區塊則是事後回頭整理累積的內容,看圖時先抓這兩個區塊的關係就好,裡面的工具名稱不用特別記。
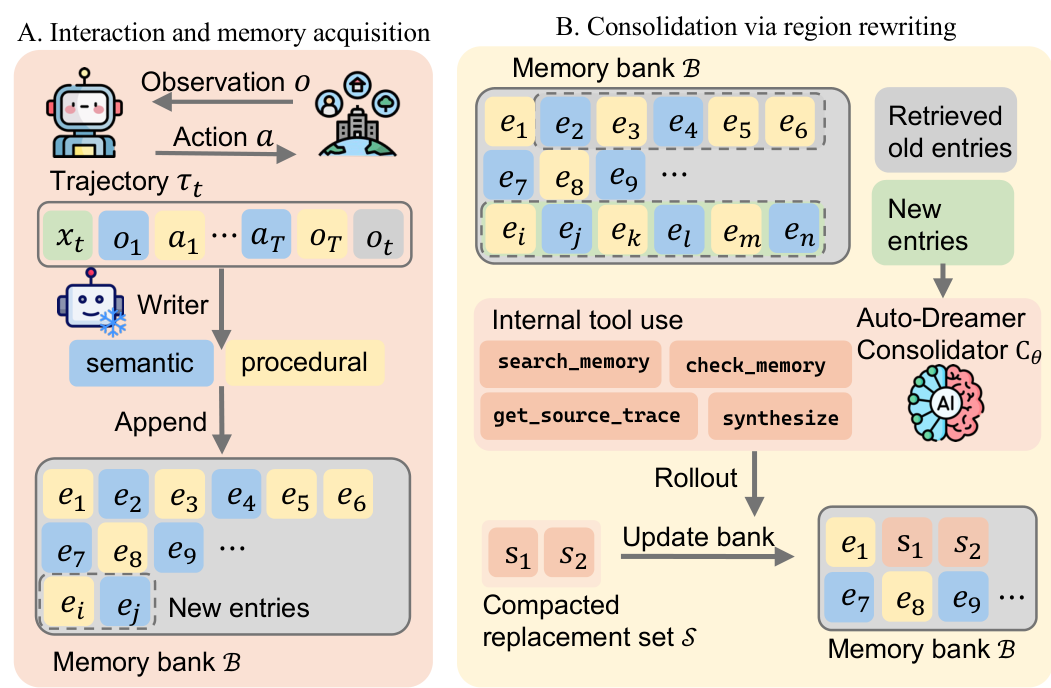
圖 2 日常記錄和事後整理是兩種工作。原圖為 Ye 等人,Auto-Dreamer,Figure 2(A)(B),2026,CC BY 4.0。
這跟我們平常工作的節奏很像,開會當下先把事情記清楚,月底再回頭整理客戶資料夾,兩件事本來就不用擠在同一個時間做,當場看不出來的重複問題,累積幾次之後反而比較明顯。不過 Auto-Dreamer 在實驗裡是固定每隔幾次工作就整理一輪,還沒有連「什麼時候該整理」都一起學會,所以還不能直接當成任何記憶庫都能放著讓它自己維護。
而且,資料也不見得都適合先壓成短短一份。萬一客戶下個月突然問起,當初為什麼改掉某個合作條件,那些平常用不到的往來細節就會變得非常關鍵,所以我還是會保留可以回查的原始紀錄,不會讓整理後的筆記變成唯一版本。
2026 年 9 月的 JAM(Just-In-Time Agent Memory)研究就走了這個方向,先把完整歷史留住,只用簡短索引幫忙定位,等問題真的出現時才去翻找並組出需要的內容。有些資料適合提前整理,有些細節可以先留著、用到再細讀,只是兩邊的代價都要一起算。少做事前整理,查詢時就得多花力氣翻找;反過來,事前整理得太勤勞,也可能白花算力在以後根本沒人問的細節上。不管選哪一邊,要是最後準備一場會議反而比以前更慢,只是筆記看起來比較整齊,老實說也沒有真的幫上忙。
有在整理,和學會整理,差在哪裡?
看到這裡,可能會有人問,這些事情寫一段 prompt 叫 AI 定期跑好像就做得到了,為什麼要特別強調「學會」?確實,我們只要下指令要它每週刪除重複內容、合併相似筆記,就能兜出一套自動整理的流程。
這類由人事先寫死規則的做法,研究裡常叫 hand-coded memory policy。如果它每次都照同一套標準整理,就算後面的工作已經變難、情境已經變了,整理方式也不會跟著調整,那我們只能說它「有在整理」,還不能說它學到了更好的整理方法。
想像我們請助理每週把客戶資料濃縮成一頁。他每次都有交差,版面也排得很漂亮,但重要的例外條件常常在濃縮時被砍掉。只要我們的驗收標準還是「有沒有縮成一頁」,他就會繼續把同一件事做得很整齊,然後讓你繼續在會議前到處救火。🫠
要讓管理方法真的進步,回饋就必須接到後面的工作結果上。這次整理讓哪個必要資訊不見了?哪份會前資料真的幫人少查了幾次信件?下次遇到類似的會議,挑選方式要不要改?從固定規則走向會根據結果調整的 learned memory policy,真正的差別就在於這條回饋有沒有接回來。
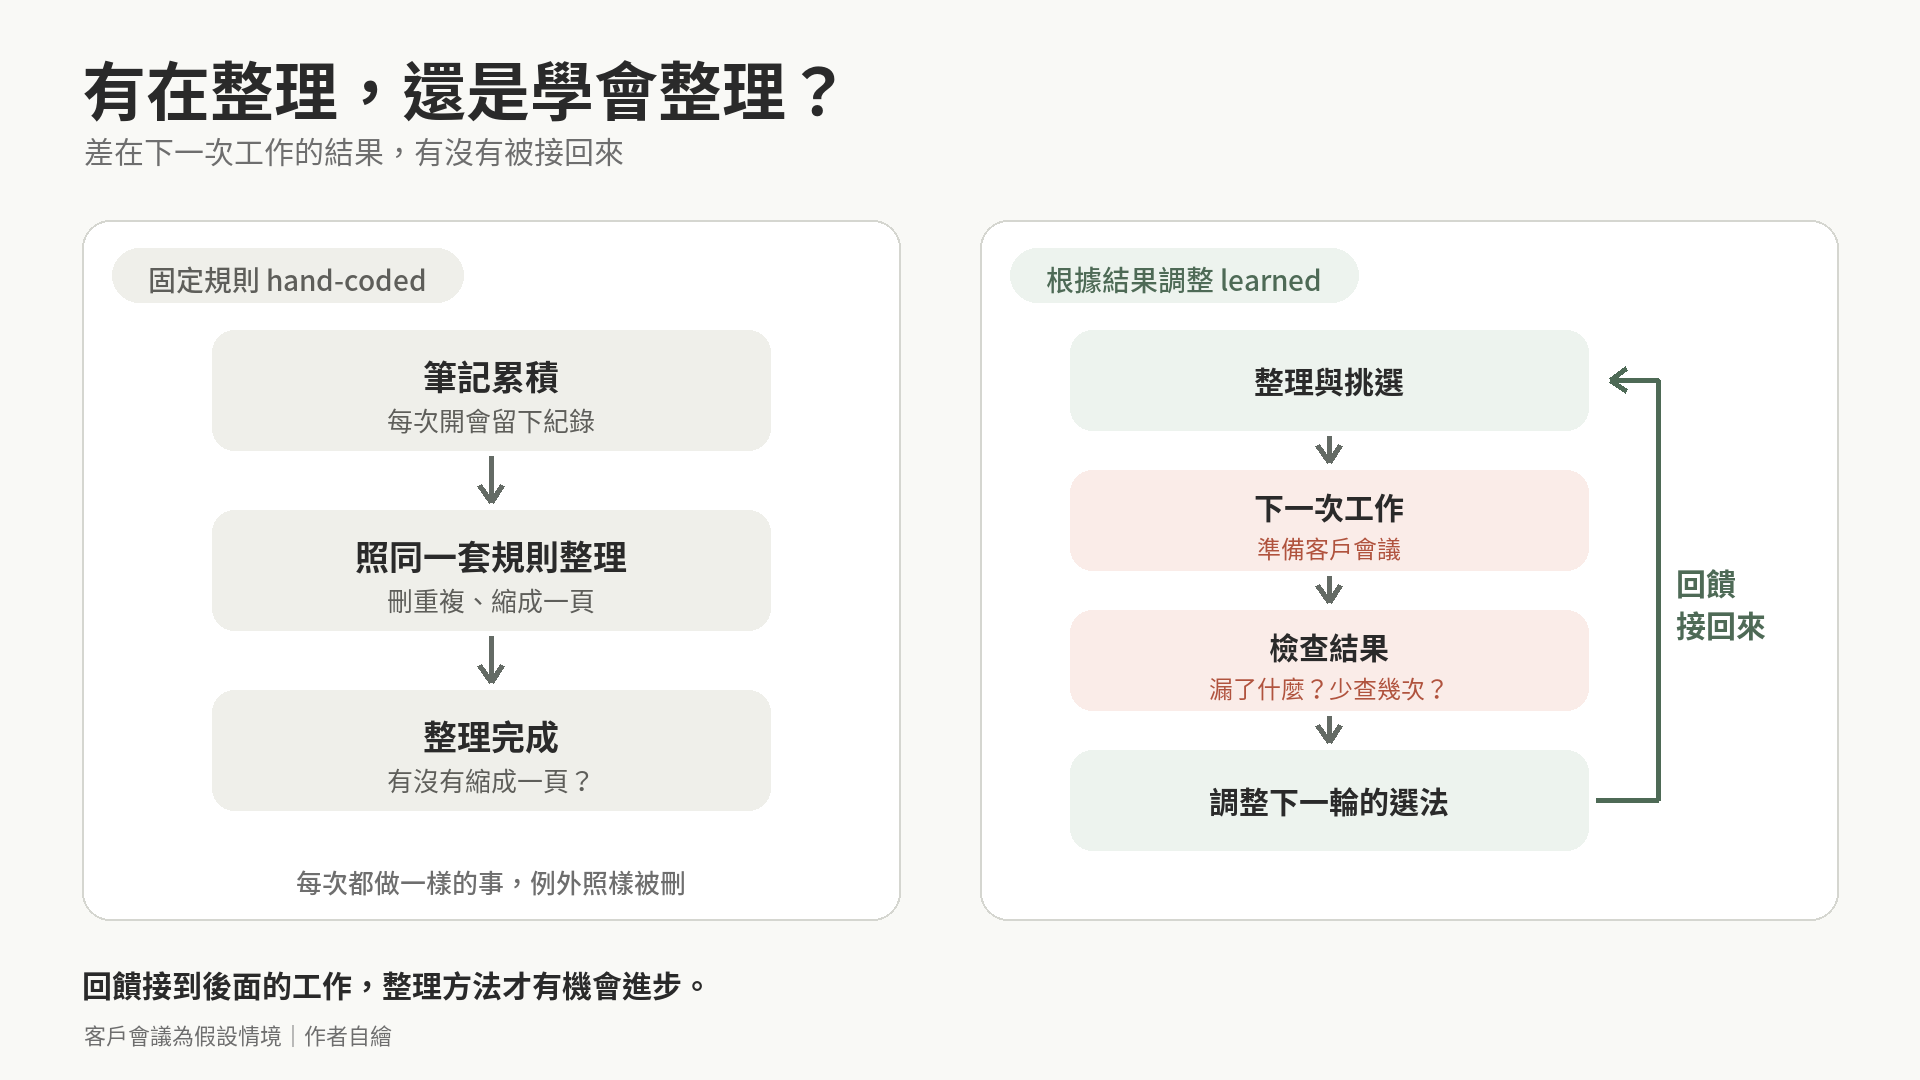
圖 3 固定規則和會根據結果調整的管理方式,差在下一次工作的結果有沒有被接回來。
這條研究路線其實已經推進了一段時間。2023 年的 MemGPT 開始嘗試讓 Agent 自己管理不同層級的記憶,決定什麼要放在眼前、什麼先收進外部儲存;前面提過的 Memory-R1 則再往前一步,直接拿任務結果的回饋去訓練這些決定。放回我們的情境,助理除了會打開資料夾,也開始有機會根據實戰結果修正自己的整理習慣。
不過這裡有一件事很容易混在一起,筆記內容一直在更新,不代表管理策略本身也在持續被訓練。拿 Auto-Dreamer 來說,它是在訓練階段把整理方式學起來,實際部署之後,就是用這個已經訓練好的整理者去更新記憶,模型參數並不會跟著每一次整理繼續改變。所以看到一套系統宣稱會自動整理記憶,我都會先問,它是在執行一套已經寫好或訓好的方法,還是有一套根據使用結果持續修正方法的流程?兩種設計都有用,只是能期待的進步幅度不同。
我也不會把「會自我管理」理解成從此不需要人設定界線。助理可以自己摸索怎麼準備客戶資料比較順手,但正式合約要保存多久、誰有權限核准優惠,還是得照公司的硬規則走,上一篇提過「讀信的 Agent 不能自己批准折扣」那道防線,也不會因為記憶管理開始學習就拿掉。
怎麼知道哪一次取捨有幫上忙?
假設我們真的要把工作結果接回來給助理當回饋,分數又該怎麼打?這次會議順利簽約,所以拿出來的筆記通通加分,沒談成就全部扣分嗎?這樣教下去,系統大概很快就會學歪。客戶最後沒簽約,很可能只是對方今年預算臨時被砍,如果助理因此把這次的資料準備方式判定為失敗,下次反而可能把原本做對的步驟給漏掉。
反過來看,一條筆記被讀取了很多次,也不能直接證明它很有價值,它可能只是剛好一直排在搜尋結果的最前面。要是系統又根據被讀取的次數替它加分、讓它排得更前面,最後我們看到的,就只是一條普通筆記在反覆替自己刷存在感。
比起看表面次數,我會更想做個對照實驗,暫時把其中幾條筆記遮起來,讓助理重做一次相同的測試工作,看看結果差在哪裡。Auto-Dreamer 的 Figure 2(D) 就是用這種遮蔽比較的方式,去估計整理後的每段內容對任務到底有沒有幫助,再把這個訊號放進訓練裡。拿掉之後表現變差的給高分,拿掉也沒差的重複內容給低分,拿掉之後表現反而變好的還會被扣分,這點跟上一篇我們在找哪條記憶害報價出錯的思路其實很像。圖裡的數字只是方法示意,不是說哪一類記憶固定會拿到那個分數。
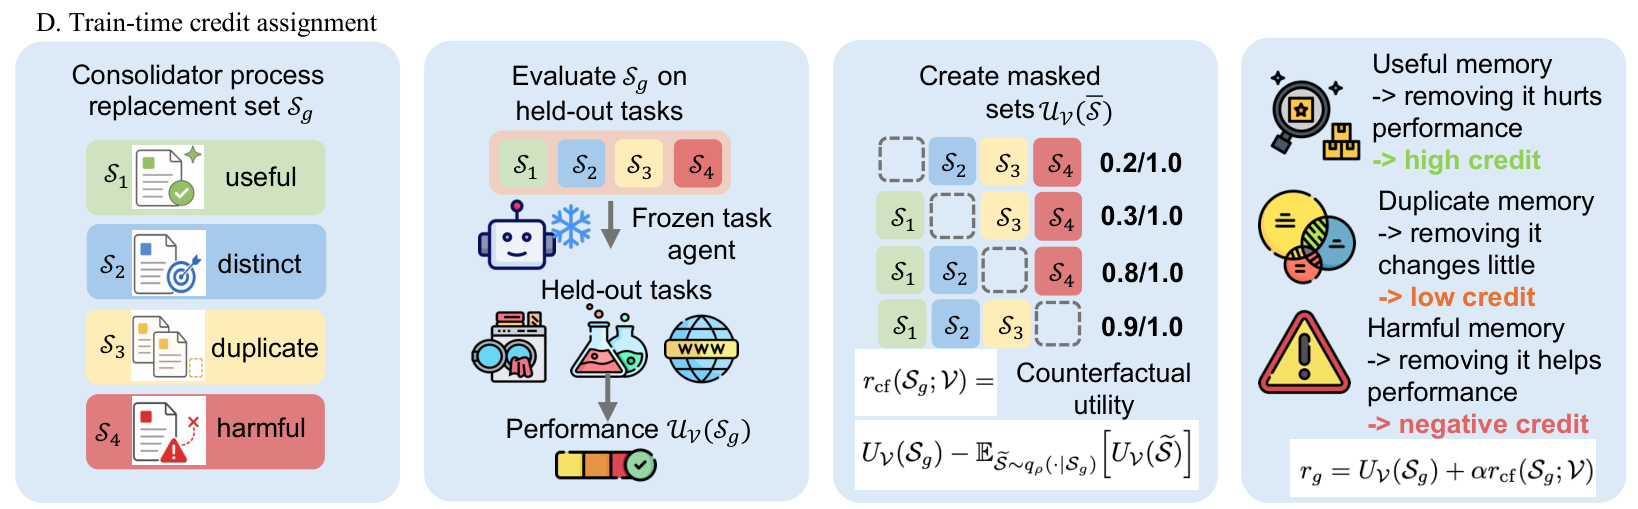
圖 4 暫時遮掉部分記憶,觀察測試結果的變化。原圖為 Ye 等人,Auto-Dreamer,Figure 2(D),2026,CC BY 4.0。
把這個做法放回會議準備,假設遮掉「付款條件還沒確認」那條提醒,助理在準備會前資料時就反覆漏掉這個必問問題,這就是它確實在幫忙的證據;相反地,拿掉重複的簡報配色紀錄,準備工作完全不受影響,那就可以考慮合併或調低優先順序。
但一次測試拿掉沒差,也不代表永遠沒用。像是一條很少動用到的解約條件,在這次例行會議裡完全沒提到,我們不能因為它這次沒幫忙拿到分數,就順手把原始紀錄刪掉,這也是為什麼前面一直強調要把「這次不需要讀」跟「原始資料不需要留」拆開來看。而且筆記之間常常會互相補位,少看 A 筆記的時候,B 筆記剛好寫到了同一件事;或者反過來,單看其中一份沒感覺,兩份擺在一起才看得懂完整限制。所以遮蔽比較給的是一條線索,實際上還是得換不同情境多跑幾輪。
這類測試也只適合放在可以重跑的環境裡做,總不能為了研究哪份筆記最有效,就在真實客戶面前故意少給一項重要說明。我會先拿助理直接負責的產出來看,例如會前資料有沒有把待確認條件列齊、提案草稿有沒有守住既有限制,這些指標比最後到底有沒有成交,更能乾淨地反映出記憶管理方式的影響。
先拿下一次工作來驗收
讀到這裡,其實不用急著自己從頭訓練一個記憶管理模型,光是先把整理方式跟下一次工作的結果接起來,就有很多能動手做的事。如果今天要在自己的系統上試,我會先挑一項反覆出現的工作,像準備客戶會議,然後先把整理前的記憶庫備份起來。
第一步先測取捨。記憶庫的資料不動,做事的 Agent 也不換,單純比較原本的取用方式,跟我們新調整的挑選方式差在哪裡。把變數鎖住,才看得出來差別是誰帶來的,不會同時換了模型、改了資料、又動了工作流程,最後變好或變壞都沒人說得準是哪一步的效果。
第二步才測維護。把同一份記憶庫複製成兩份,一份維持原樣,另一份交給整理流程去合併跟改寫,整理完之後,再拿同一批新的會議需求去測兩邊的表現。這批測試問題不能事先洩題給負責整理的模型,不然它只要專門替這幾題留答案就好;測試時開的新對話,也只給正常情況下拿得到的記憶與工具,不帶入整理當下的討論過程。畢竟整理的時候聊得頭頭是道,跟下次開新對話真的找得到,完全是兩回事。
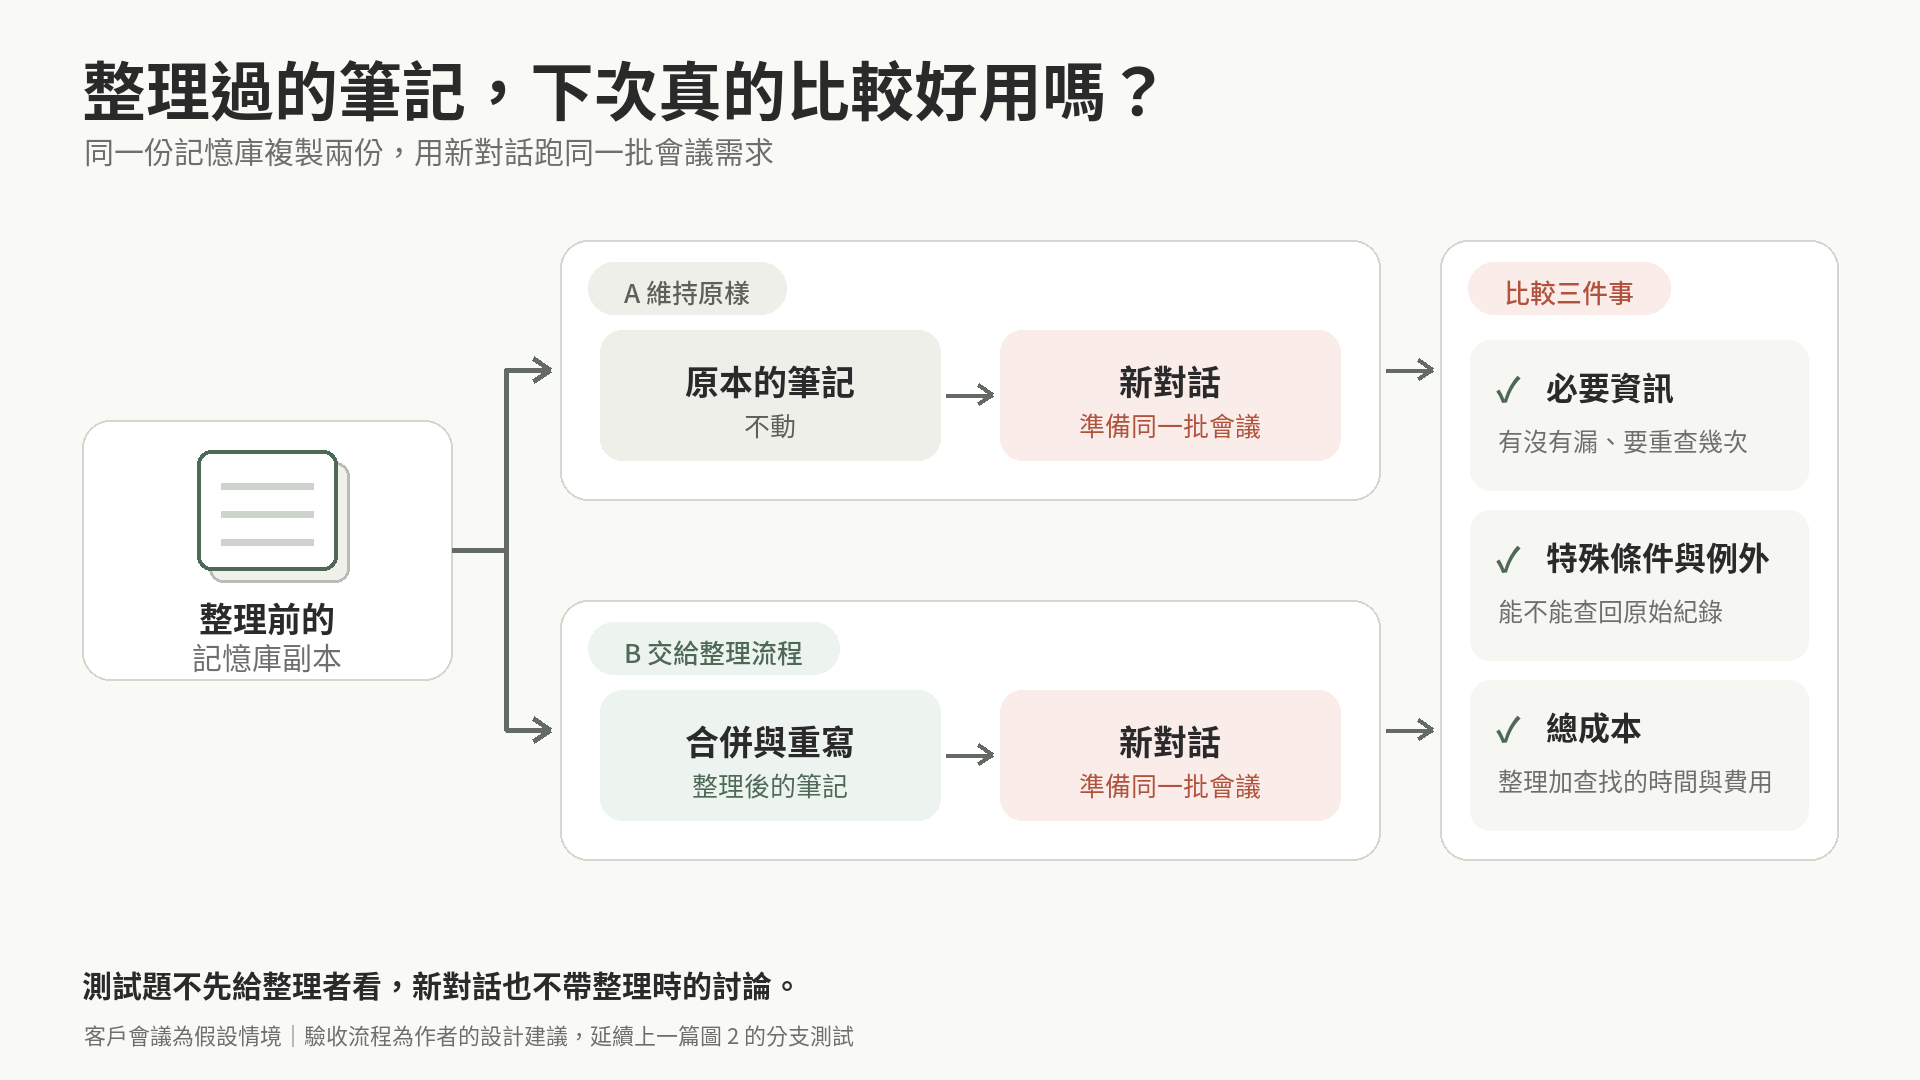
圖 5 維持原樣和整理過的兩份記憶庫,用新對話跑同一批會議需求。做法延續上一篇圖 2 的分支測試。
跑完對照之後,我大概會看以下三件事。
會前準備有沒有更完整,必要資訊有沒有漏,人還需要自己回頭翻幾次資料
特殊條件與例外有沒有被留住,需要求證時能不能順著連回原始紀錄
把事前整理跟事後查找花掉的時間、費用加總起來,整個工作流程有沒有真的變省事
先在副本上跑完驗收,萬一這輪整理沒通過,隨時都能退回前一版,不用急著覆蓋正式在用的筆記;要是發現某幾類工作表現變差,也能直接比對兩份記憶庫,抓出到底是哪段關鍵資訊在濃縮時被洗掉了。如果未來想進一步讓系統持續學習怎麼挑選記憶,這些對照紀錄也是最基本的起點。我們得先記下當時有哪些候選資料、實際挑了哪些、最後工作結果如何,系統才學得會下次怎麼選,只給一句「這次做得不錯」是教不會它的。
我自己也在把這套驗收流程放回 Cairn 對照,先拿一項反覆發生的工作,看記憶的取捨與整理能不能真的減少重做,再慢慢放大範圍。畢竟光是在介面上多做一個自動整理的按鈕,還回答不了這個問題,上面的做法我也還在逐項實測,還不能算成產品已經做到的事。
回到一開始那場客戶會議,我期待的改變其實很單純。下一次請 AI 準備開會資料時,我不用再從它交上來的長篇摘要裡,自己重新翻出今天真正要拍板的事;真碰到特殊例外,它也留好了路,讓我隨時查得回當初是怎麼談的。
再往下想一步,如果業務、財務和客服都有各自的 Agent,每個人都整理出一套自己覺得最好用的客戶筆記,當這些記憶放到同一個團隊裡共用,又會發生什麼事?最後一篇,我們就來聊,當 Memory 從「我的」變成「我們的」。
參考資料
研究查閱日期:2026 年 10 月 27 日。各研究的能力與成效限於各自的實驗設定。
MemComposer(2026 年 10 月):https://arxiv.org/abs/2610.21091
Auto-Dreamer(2026 年 5 月),圖 2、圖 4 出自 Figure 2,PDF 第 5 頁:https://arxiv.org/abs/2605.20616v1
JAM / Just-In-Time Agent Memory with Runtime Agentic Research(2026 年 9 月):https://arxiv.org/abs/2609.34385
MemGPT(2023):https://arxiv.org/abs/2310.08560
Memory-R1(2025):https://arxiv.org/abs/2508.19828
作者:Chi