#1 大家都在講 Agent Memory,但「記憶」到底存在哪裡?
以前我們可能會覺得,只要把 RAG 做好、把 Context Window 塞滿,AI 就可以變聰明了。結果實際去兜 Agent 系統才發現,很多時候你痛的根本不是它答不出新知識,而是它忘記你們昨天才剛走過的血淚教訓。
最近我花了不少時間在研究 AI Agent 的 Memory,越看越覺得這個領域有一個很有趣的問題:
現在大家嘴巴裡講的「Memory」,其實常常根本不是同一件事。
有人說 Memory 是把 ChatGPT 的歷史對話存起來;有人把 MEMORY.md 當成 Memory;Mem0、Zep 這類產品也在做 Memory;RAG 從 Vector DB 找資料,有時也被放進 Memory 的討論;再往模型底層看,fine-tuning、KV Cache、甚至模型參數裡的知識,也都有人用「記憶」來描述。
全部混在一起之後,很容易變成:
反正只要 AI 可以把以前的東西拿回來,都叫 Memory。
但這樣其實很難討論,因為不同研究和產品,根本在解不同的問題。
所以最近我想花幾篇文章,重新把 Agent Memory 到底是什麼整理一次。
我不打算單純做 paper summary,比較想從我們現在真的在做系統時會碰到的場景出發:Memory 存在哪裡?Agent 到底要記什麼?一段資訊怎麼變成 Memory?記憶過期了怎麼辦?甚至到了多人 Agent 之後,誰有資格修改共享記憶?
剛好去年底有一篇很完整的 Survey,叫做 《Memory in the Age of AI Agents》。這篇 paper 點出一個關鍵:現在 Agent Memory 相關的研究真的太分散了,傳統用「短期記憶 / 長期記憶」來分類,已經不太能描述現在的系統。作者甚至在正式介紹分類前,就先決定把 Agent Memory、LLM Memory、RAG 與 Context Engineering 拆開來看。(arXiv)
這整個大題目我目前預計會拆成 8 篇,分「第一季(打地基)」跟「第二季(深水區)」來連載。老實說,一口氣挖這麼大的坑我也滿怕自己填不完的 😅。
總之第一集,我們就先從「把最容易搞混的名詞全部分開」開始。
都叫 Memory,但其實在回答不同問題
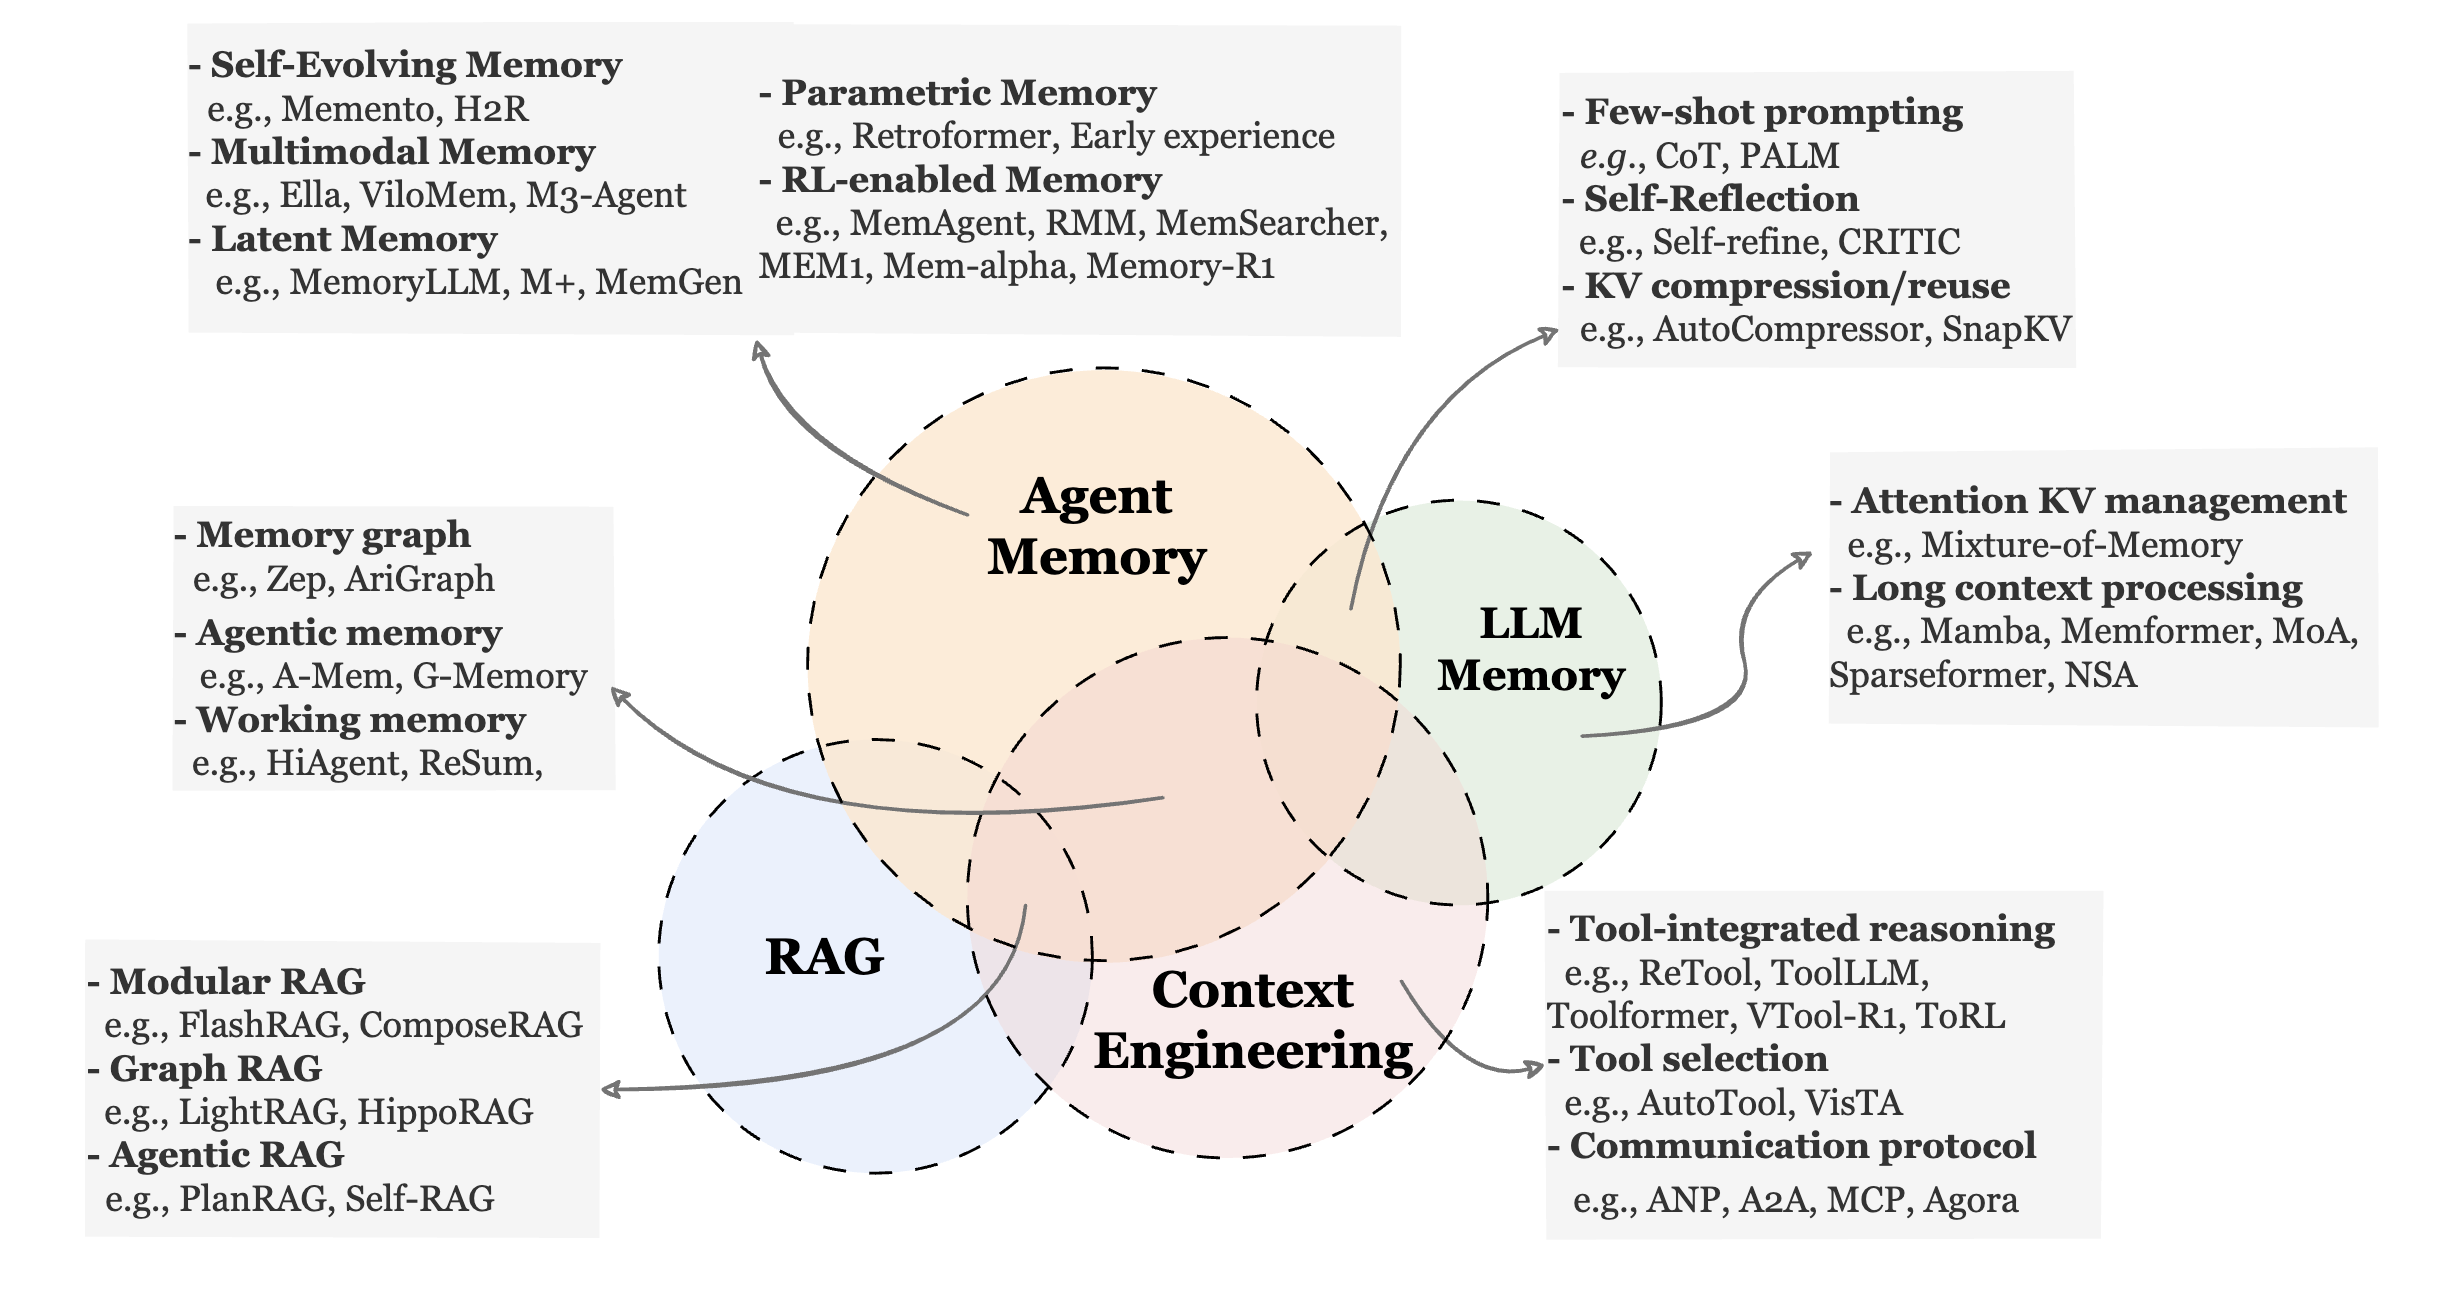
就像這張論文裡的文氏圖畫的一樣,現在這些錯綜複雜的名詞,其實可以大致切成四個不同維度的領域:LLM Memory、RAG、Context Engineering,以及真正的 Agent Memory。
與其去硬背它們的定義,我自己目前會選擇用四個「反問」來理解它們真正的差別:
1. LLM Memory:模型本身「記得」什麼?
如果今天研究的中心是 LLM 本身,例如:
資訊如何編碼進模型參數
模型怎麼維持長 context
inference 過程中的 internal state
過去資訊怎麼持續影響模型計算
這比較接近 LLM Memory 的問題。
它關心的對象首先是 model。
簡單來說,可以先想成:
模型本身如何保存與利用過去資訊?
這可能一路深入到 parameters、KV state 等比較 model-level 的機制。這和我們平常說「Agent 記得我喜歡喝拿鐵」,其實不是完全同一層次的事。
2. RAG:這一題回答之前,我應該先找什麼資料?
RAG 又是另一件事。它的核心問題是:
現在要回答這個 Query,我應該從外部 knowledge source 找哪些資訊?
最典型的 RAG,就是把大量資料切 chunk、丟進 Vector DB,然後讓 LLM 檢索回答。
但這裡很容易出現一個誤會:
用了 Vector DB,不代表你就做了 Agent Memory。
假設我把公司 10,000 份 SOP 丟進 Vector DB 讓 Agent 搜尋。這當然是一個不錯的 Knowledge Retrieval System。
但 Agent 昨天犯了一個錯、被工程師修正了,今天它會不會因此改變?
不一定。
也就是說:
簡單來說,RAG 是去查已經寫好的知識,而 Agent Memory 是學會記住自己跌過的跤。
RAG 解決的是「我原本不知道」,但 Agent Memory 要解的其實是「我不要再犯跟昨天一樣的錯」。
這也是為什麼那篇 survey 會刻意把 RAG 和 Agent Memory 分開處理。(arXiv)
3. Context Engineering:這一次到底要讓模型看到什麼?
Context Engineering 最近也很常跟 Memory 綁在一起討論。
但我自己的感覺是,用一句話就能把這兩件事切開:
Memory 是你擁有什麼;Context Engineering 是這一刻你要讓模型看到什麼。
例如一個 Coding Agent 接到任務,呼叫模型前的 context 裡可能同時包含:
System Instructions
Project Rules
Current Task
Conversation History
Tool Results
Retrieved Memory
Relevant Code
Memory 只是其中一種 input。
Context Engineering 真正關心的是:
這次呼叫只有有限的 context budget,我到底該塞哪些東西進去?
因此你完全可能擁有超大容量的 Memory,但這次一條都沒拿出來;又或是沒有實作長期 Memory,但透過極好的 context construction,就讓 Agent 跑得很順。這兩者互為表裡,但不能畫上等號。
4. Agent Memory:過去的經驗,怎麼持續改變未來的行動?
到了真正的 Agent Memory,我覺得問題變得有點不太一樣了。
Agent 已經不只是 Input → LLM → Output,而是會跟環境反覆互動、執行 Action、得到 Outcome,再進行下一次 Action。
這時候 Memory 真正重要的地方在於:
過去發生過的事,能不能持續影響下一次的判斷與行動?
舉個實際踩坑的例子:
Agent 上次 Deploy 時出包了。
工程師火大修理並告訴它:
Production migration 前一定要先確認 backward compatibility。
這段教訓被留了下來。
三週後,另外一個 task 又碰到 migration,Agent 主動拿出這條經驗,改變了自己的 plan。這就比單純「從 memory 搜到 migration 說明檔案」更接近我們現在談的 Agent Memory 核心。
而且 Agent Memory 還有一個非常重要的特性:它是會變的。
Agent 做了一件事 → 形成新 Memory。
發現舊經驗不對 → 修改 Memory。
兩段經驗互相衝突 → merge、保留 disagreement,或者讓其中一條失效。
需要完成新任務 → 再把適合的 Memory 撈回來。
這也是《Memory in the Age of AI Agents》後續用 Forms、Functions、Dynamics 三個維度來描述 Agent Memory 的原因。(arXiv)
同一個技術,也可能是在做完全不同的事情
把這幾個概念拆開之後,有一件事突然變得很清楚:
技術實作,並不能直接告訴你這是不是 Agent Memory。
例如都是 Vector DB:
情境 A
公司文件 → Vector DB → 回答員工問題這就是 RAG。
情境 B
Agent execution → 萃取失敗經驗 → Vector DB → 下次任務重新使用這就開始接近 Agent Memory。
老實說,這兩種系統底層甚至可能都是兜同一個 PostgreSQL + pgvector。現在很多人其實只是把歷史 chat history 一路塞進 database,就對外說自己做了 Memory,但那充其量只是一個 archive 而已 😅。
真正不同的是:
這份資訊在整個 Agent lifecycle 中扮演什麼角色。
同樣地,像 Agent 會建立的 MEMORY.md 也只是一個儲存形式。
真正該問的是:
誰會把內容寫進去?
寫的是客觀事實還是主觀經驗?
什麼時候會更新?
舊的東西怎麼失效?
Agent 什麼時候會讀?
最關鍵的:讀完之後有沒有真的改變它的行動?
問到這裡,Memory 才真正從一個死板的「檔案」,變成一套活的「機制」。
接下來:把這件事拆成「兩季」來看
所以這篇就當作整個系列的前哨站。這個坑滿大的,我打算把它拆成兩季來寫:
第一季:搞懂 Agent Memory 的地基
如果你正在實作 Agent,前四篇主要是幫我們建立一套實用的共同語言,看懂現在各家工具到底在做哪一塊:
#1 大家講的 Memory 是一樣的嗎?(也就是這篇)
#2 記憶到底存在哪裡? (Token-level 到各種架構)
#3 Agent 到底需要記住什麼? (Working 到 Experiential Memory)
#4 Memory 怎麼形成、更新與消失? (Formation 到 Forgetting)
第二季:Agent Memory 的深水區
第一季打好地基後,我覺得後面的發展其實更迷人。因為現在不管學界還是業界,都開始不得不面對一個殘酷的現實:就算 Agent「記得」,也不代表它記對了;就算它記對了,也不代表你能相信它。
所以第二季,我們會往更底層的落地挑戰走:
#5 記住了,就代表記對了嗎? (過期、幻覺與衝突)
#6 當 Memory 也開始被攻擊 (安全性與 Poisoning)
#7 Agent 能不能自己學會管理記憶? (Learned memory policy)
#8 當 Memory 從「我的」變成「我們的」 (共享記憶的治理)
這就是接下來這個系列的完整藍圖。老實說,寫到第二季這些深水區時,我們面對的問題早就超越「要把對話存在哪個 Vector DB」的層次了。
Memory 最後要解的,終究不是「保存」
如果要替這個系列留一句暫時的小結,我自己的感覺是:
Agent Memory 是一套讓過去的資訊與經驗,可以持續影響未來行動的機制。
所以,Memory 的終點絕對不會是:
我成功把 100 萬條對話 log 存下來了。
而是:
Agent 因為記得,所以這一次,它做得不一樣了。
如果用這個視角去看,後續的實作細節會變得非常好玩。第一季下一篇我們就先從最基本的開始:
記憶到底存在哪裡?
來看看為什麼 MEMORY.md、Vector DB、Knowledge Graph、Fine-tuning 和 hidden state 這些五花八門的東西,居然都會出現在同一張 Agent Memory 工具箱裡。
作者:Chi